Embeddings et recherche documentaire
L'Atelier IA transforme ses PDF en extraits indexés. Un modèle d'embeddings représente le sens du texte pour retrouver les passages proches de votre question. Le modèle de chat utilise ensuite ces passages pour rédiger la réponse.
Ces deux modèles se règlent séparément. Un chat cloud peut donc utiliser des embeddings Ollama locaux, et inversement.
Configurer les embeddings
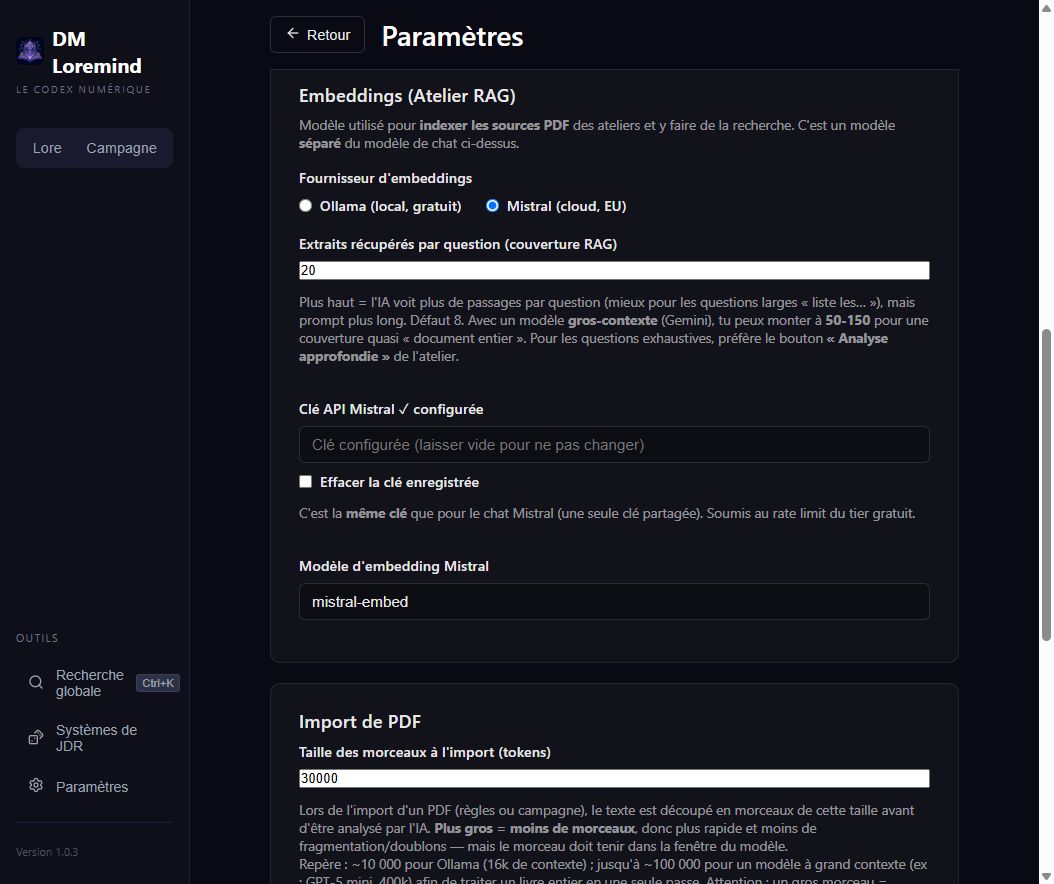
Dans Paramètres → Embeddings (Atelier RAG) :
- Choisissez Ollama ou Mistral.
- Pour Ollama, vérifiez que le service est accessible et choisissez un modèle
d'embeddings (par défaut
nomic-embed-text). Le téléchargement automatique peut être activé. - Pour Mistral, configurez la clé API Mistral et le modèle d'embeddings
(par défaut
mistral-embed). La clé est partagée avec la configuration du chat Mistral. - Ajustez au besoin le nombre d'extraits récupérés par question.
- Cliquez sur Sauvegarder, puis ajoutez un PDF dans un atelier et attendez son état Prêt.
Un modèle de conversation Ollama ne remplace pas un modèle d'embeddings : les deux doivent être disponibles pour un usage entièrement local de l'Atelier.
Régler la couverture
Le nombre d'extraits, ou top-K, vaut 8 par défaut dans la configuration du service. Augmenter cette valeur fournit davantage de texte au chat, mais allonge son contexte et peut ralentir la réponse.
Pour une question ciblée, commencez avec la valeur par défaut. Pour une liste exhaustive, sélectionnez les bonnes sources et utilisez plutôt l'analyse approfondie de l'atelier, qui parcourt leur texte au lieu de se limiter aux passages les plus proches.
Les réglages taille des morceaux d'import PDF et timeout IA concernent l'analyse de règles ou de campagnes. Ils ne représentent pas le nombre de passages récupérés par une question RAG.
Après un changement de modèle
Un index dépend du modèle qui l'a produit. Après un changement de fournisseur ou de modèle d'embeddings, réindexez les documents avec le nouveau modèle ; si votre version ne propose pas de commande de réindexation, réajoutez les PDF dans un nouvel atelier. Conservez les sources et l'ancien atelier tant que vous n'avez pas vérifié les nouvelles réponses.
Où passe le texte ?
Avec Mistral pour les embeddings, les extraits à indexer sont envoyés à son API. Avec un chat cloud, les passages retenus sont aussi transmis au fournisseur du chat, même si les embeddings sont locaux. Pour garder ce traitement sur votre machine, utilisez Ollama pour les deux fonctions. Voir Données et partage.